問6簡単
気象庁が現在運用している天気予報ガイダンスについて述べた次の文 (a) 〜 (d) の正誤の組み合わせとして正しいものを、下記の1〜5の中から1つ選べ。
(a) 天気予報ガイダンスの主な役割として、数値予報モデルによる予測値を補正することや、数値予報モデルが直接予測していない要素を予測することが挙げられる。
(b) 降水、気温、風のガイダンスは、数値予報結果に含まれている系統誤差とランダム誤差の両方を統計的に補正することができる。
(c) 数値予報モデルでは海陸の区別が実際と一致していない格子点がある。降水、気温、風のガイダンスは、海陸の区別の不一致に起因する数値予報モデルの予測誤差を低減することができる。
(d) 数値予報モデルの改良等によりその予測特性が変化した場合でも、カルマンフィルタに基づく天気予報ガイダンスでは、予測と観測を繰り返すことでガイダンスに用いる予測式の係数が変化するので、数値予報モデルの変更に柔軟に対応することができる。
本問は、気象庁が現在運用している天気予報ガイダンスに関する問題です。
ガイダンス(予備知識)
ガイダンス とは、数値予報モデルの予測値を統計的に補正したり、数値予報モデルが直接出力していない情報を作成したりすることで、予報作業を支援する資料のことです。
例えば、数値予報モデルが予測した気温や風、湿度、降水量などの値をもとに、より実際の観測に近い予測値を求めたり、晴れ・曇り・雨などの天気カテゴリーや発雷確率などを作成したりします。
簡単にいうと、ガイダンスは、数値予報モデルの計算結果を、私たちが普段見る天気予報に「翻訳」する仕組みと考えるとイメージしやすいでしょう。
下図は、ガイダンスのイメージを表したものです。
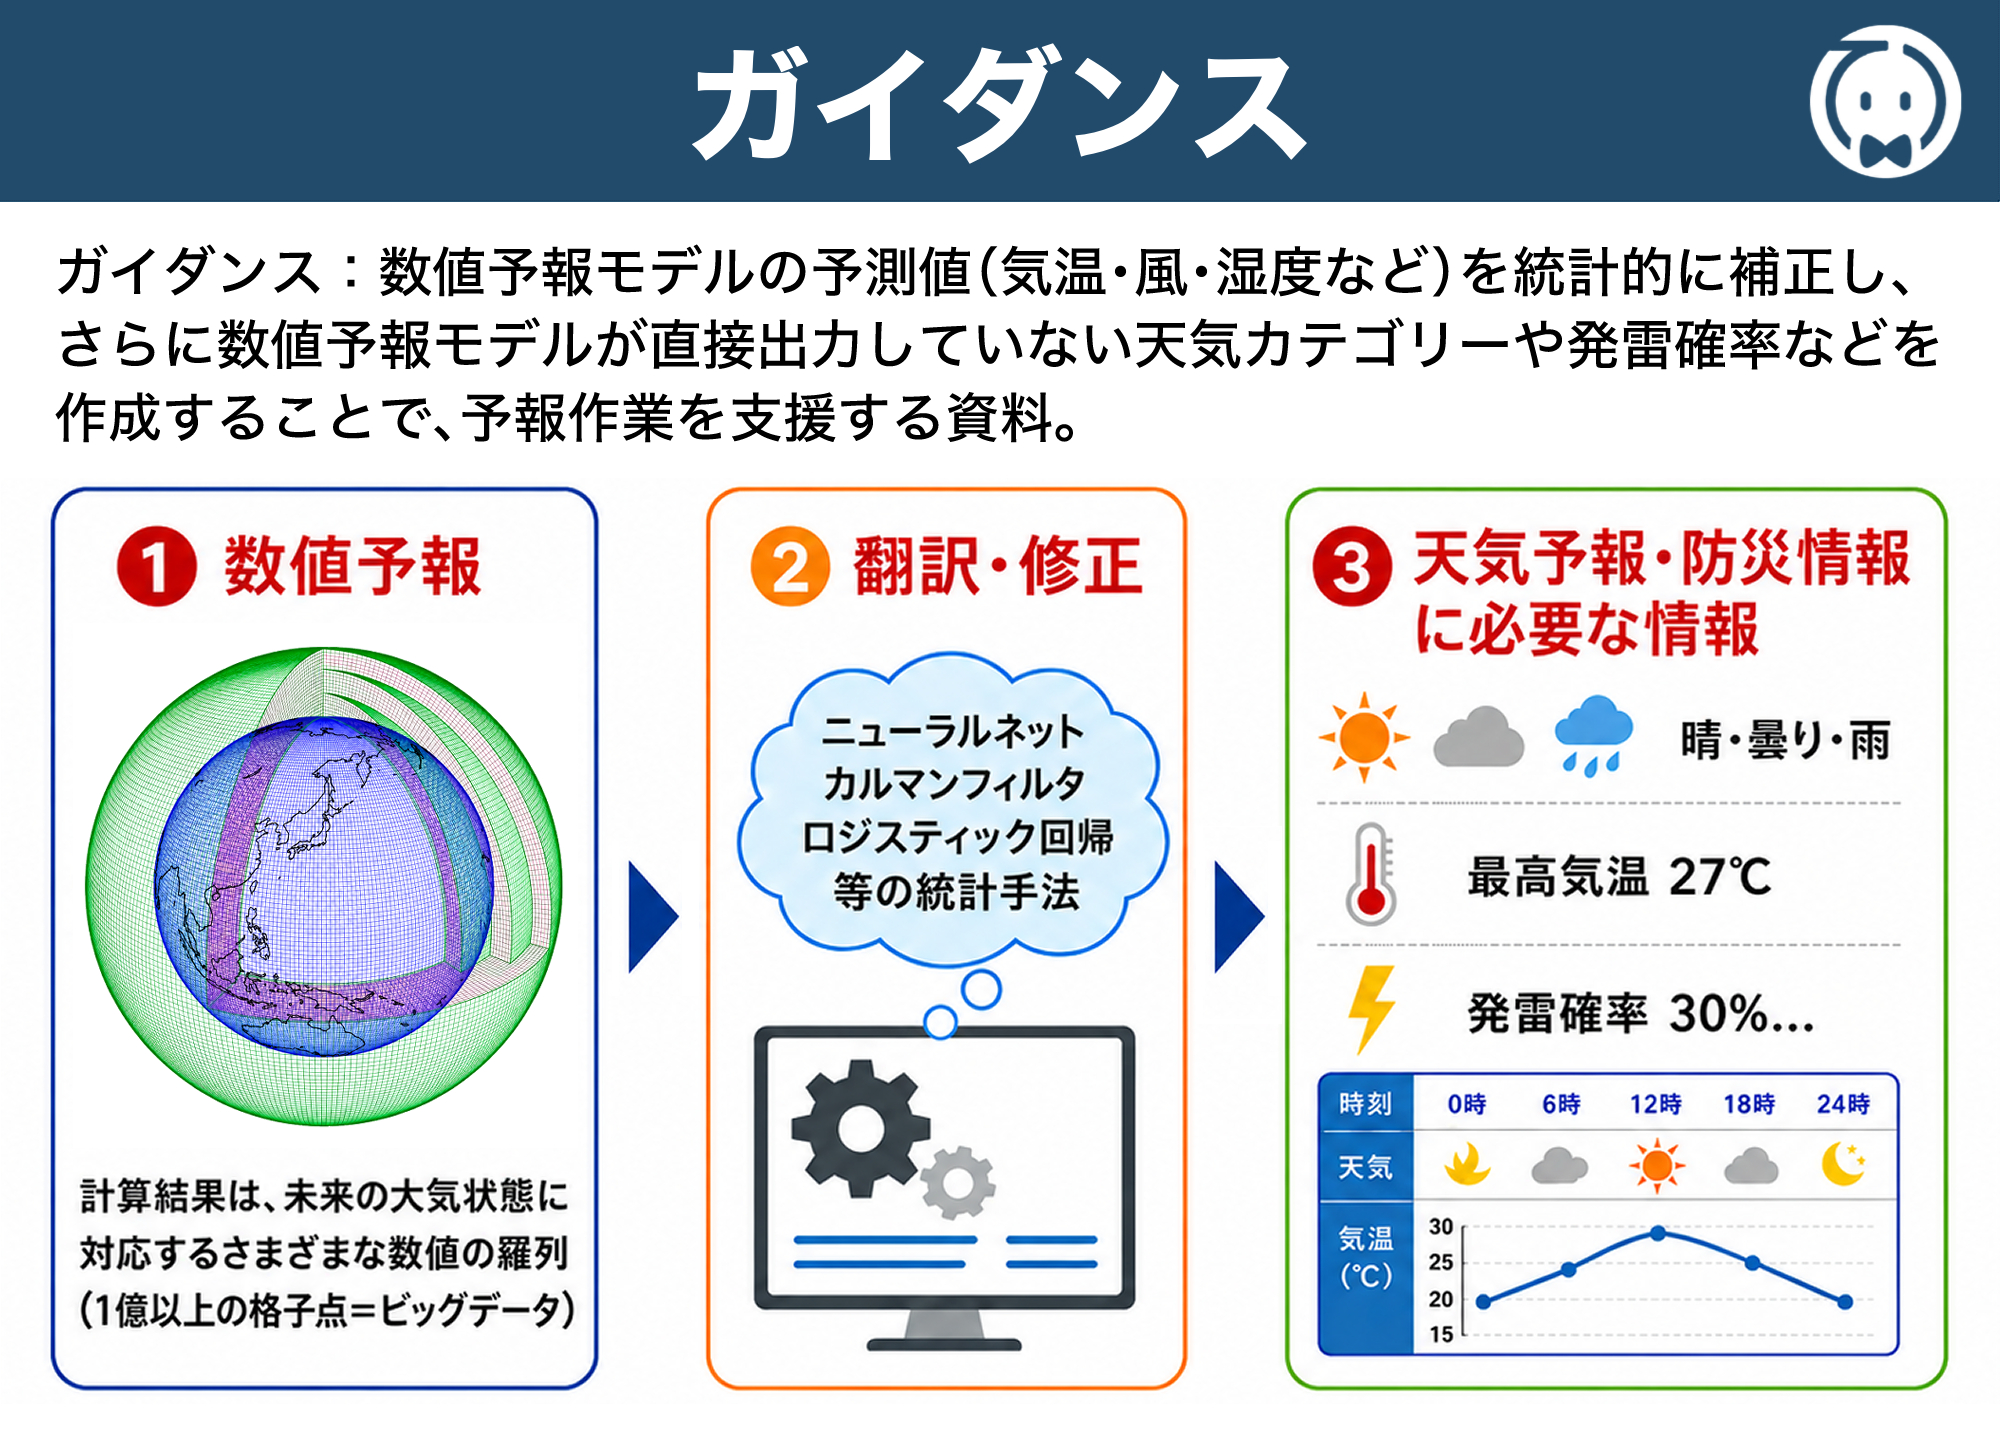
数値予報モデルでは、コンピューターを使って大気の状態を計算し、未来の気温や風、湿度、降水量などを膨大な数値として予測しています。
しかし、数値予報モデルの予測値には、モデルの特性などによる誤差が含まれています。
また、数値予報モデルだけでは、晴れ・曇り・雨などの天気カテゴリーや発雷確率などを直接予測できないものもあります。
そこで、過去の数値予報の予測値と実際の観測データを比較し、その関係から統計的な予測式を作ります。
そして、その予測式を最新の数値予報の予測値に当てはめることで、数値予報の誤差を補正した予測値や、数値予報モデルが直接出力していない情報を作り出します。
これが ガイダンス です。
ガイダンスでは、予測する要素に応じて、さまざまな統計的手法が使われています。
例えば、カルマンフィルタ、ニューラルネットワーク、ロジスティック回帰などがあり、それぞれの特徴に応じて使い分けられています。
 てるるん
数値予報モデルが計算した膨大な数値を、そのまま使うんじゃなくて、過去の予測と観測の関係を利用して補正したり、天気カテゴリーや発雷確率などに変換したりするんだよ!
このように、ガイダンスは、数値予報モデルの結果を予報に利用しやすい形に「翻訳」することで、予報作業を支援しているのです。
それでは、選択肢を1つずつ見ていきましょう。
本問の解説:(a) について
(問題)天気予報ガイダンスの主な役割として、数値予報モデルによる予測値を補正することや、数値予報モデルが直接予測していない要素を予測することが挙げられる。
→ 答えは 正 です。
天気予報ガイダンスには、大きく分けて2つの役割があります。
1つ目は、数値予報モデルの予測値を補正することです。
気温や風、降水量などは数値予報モデルによって予測できますが、その予測値には、モデルで表現している地形と実際の地形との違いなどによって、ある程度決まった傾向の誤差( 系統誤差 )が生じることがあります。
そこでガイダンスでは、過去の数値予報の予測値と、実際の観測値を統計的に比較し、どのような誤差が生じやすいのかを調べます。
そして、その傾向を利用して数値予報モデルの予測値を補正し、より実際の天気に近い予測を作ります。
2つ目は、数値予報モデルが直接予測していない要素を予測することです。
数値予報モデルは、晴れ・曇り・雨といった天気カテゴリー、降水確率、発雷確率、視程などは、予測していません。
そこでガイダンスでは、数値予報モデルが予測した気温や風、降水量などの情報と、過去の観測データとの関係を利用して、これらの要素を予測します。
 てるらん
「数値予報の誤差を直す」と「数値予報にない要素を予測する」の2つが、ガイダンスの大きな仕事なんだね!
したがって、天気予報ガイダンスの主な役割として、数値予報モデルによる予測値を補正することや、数値予報モデルが直接予測していない要素を予測することが挙げられますので、答えは 正 となります。
本問の解説:(b) について
(問題)降水、気温、風のガイダンスは、数値予報結果に含まれている系統誤差とランダム誤差の両方を統計的に補正することができる。
→ 答えは 誤 です。
数値予報の誤差には、大きく分けて「系統誤差」と「ランダム誤差」の2種類があります。
系統誤差 とは、場所や時刻などによって、統計的に見たときに同じような傾向で現れる誤差のことです。
例えば、この地点では、数値予報の気温がいつも実際より低めに出るといった、決まった傾向をもつ誤差などがあります。
ランダム誤差 とは、決まった傾向がなく、そのときどきで大きさや方向が変わる誤差のことです。
例えば、数値予報モデルが前線や低気圧の位置を実際とは異なる場所に予測したり、低気圧の発生や発達を正確に予測できなかったりすることで生じる誤差などがあります。
系統誤差が生じる主な原因には、次のようなものがあります。
- 数値予報モデルの地形(標高・起伏)と実際の地形との違い
- 数値予報モデルの海陸分布と実際の海陸分布との違い
- 数値予報モデルそのものの不完全性
下図は、モデル地形と実際の地形の違いによって、系統誤差が生じる例です。

上図の地点Aは、実際には急斜面で地形性の降水が多い場所ですが、モデル地形ではなだらかな地形として表現されています。
そのため、数値予報では降水量が実際より少なめに予測される傾向があります。
一方、地点Bは、実際には谷になっていて標高が低い場所ですが、モデル地形ではその谷が十分に表現されていません。
そのため、数値予報では気温が実際より低めに予測される傾向があります。
このように、系統誤差は「いつも同じような方向にずれる」という特徴があります。
そのため、過去の数値予報と観測データを比較することで、その誤差の傾向を統計的に把握し、補正することができます。
一方、ランダム誤差は、事例ごとに誤差の原因や現れ方が異なります。
そのため、過去のデータから「いつもこのようにずれる」という一定の傾向をつかむことができず、統計的に補正することはできません。
例えば、数値予報で前線の位置が実際より西にずれていた場合、ガイダンスがその位置ずれそのものを修正して、気温や風などを計算し直すことはできません。
 てるらん
前線の位置がずれていたら、ガイダンスでは直せないの?
てるるんガイダンスは、過去のデータから分かった「いつものずれ」を直すものだから、そのときだけ発生した前線の位置ずれまでは直せないんだよ!
したがって、降水、気温、風のガイダンスが統計的に補正できるのは 系統誤差 だけであり、ランダム誤差は補正することができませんので、答えは 誤 となります。
本問の解説:(c) について
(問題)数値予報モデルでは海陸の区別が実際と一致していない格子点がある。降水、気温、風のガイダンスは、海陸の区別の不一致に起因する数値予報モデルの予測誤差を低減することができる。
→ 答えは 正 です。
数値予報モデルでは、大気を格子状に区切り、それぞれの格子が「海」なのか「陸」なのかを決めて計算しています。
しかし、1つの格子にはある程度の広さがあるため、格子よりも小さな島や、複雑に入り組んだ海岸線などは、実際の海陸の分布をそのまま表現することができません。
下図は、実際の地形とメソモデル(MSM)の地形を比較したものです。

上図を見ると、実際の地形では新島(にいじま)がありますが、MSMの地形では新島が表現されず、海として扱われていることが分かります。
このように、実際は陸があるのに、数値予報モデルでは海として計算されてしまうことがあるのです。
海と陸では、地表面の性質が大きく異なります。
例えば、海は陸に比べて温まりにくく、地表面摩擦も小さいです。
そのため、実際には陸がある場所を海として計算すると、気温や風、降水などの予測に誤差が生じてしまうことがあります。
このような海陸の区別の違いによって生じる誤差は、同じ場所で同じような傾向で現れやすいため、系統誤差と考えることができます。
系統誤差は、過去の数値予報と実際の観測データを比較することで、その傾向を統計的に把握することができます。
そのため、ガイダンスでは、このような過去の誤差の傾向を利用して、海陸の区別の不一致によって生じる数値予報モデルの予測誤差を低減します。
てるらん海と陸の区別が実際と違っていても、同じような誤差が繰り返し出るなら、その傾向を利用してガイダンスで補正できるんだね!
したがって、降水、気温、風のガイダンスは、海陸の区別の不一致に起因する数値予報モデルの予測誤差を低減することができますので、答えは 正 となります。
本問の解説:(d) について
(問題)数値予報モデルの改良等によりその予測特性が変化した場合でも、カルマンフィルタに基づく天気予報ガイダンスでは、予測と観測を繰り返すことでガイダンスに用いる予測式の係数が変化するので、数値予報モデルの変更に柔軟に対応することができる。
→ 答えは 正 です。
カルマンフィルタ とは、新しい観測データが得られるたびに、予測式の係数を少しずつ更新していく統計的な手法のことです。
簡単にいうと、「予測する → 実際の観測と比べる → 予測式を調整する」という作業を繰り返しながら、予測式を少しずつ改善していく仕組みです。
気象庁のガイダンスでは、気温、風、降水量などの予測にカルマンフィルタが用いられています。
ガイダンスでは、数値予報モデルが予測した気温や風、降水量などの値をもとに、補正後の予測値を求めます。
もう少し専門的に言うと、数値予報の予測値などを「説明変数」として、ガイダンスによる補正後の予測値である「目的変数」を求めます。
このときに使われる予測式には、それぞれの説明変数をどの程度利用するかなどを決める「係数」があります。
カルマンフィルタでは、この係数を最初から固定しておくのではなく、新しい観測データが得られるたびに更新していきます。
例えば、最初は数値予報が実際の気温より低めに予測することが多かったとしても、観測データを繰り返し取り込むことで、その傾向に合わせて予測式の係数が少しずつ変化していきます。
このように、新しいデータが得られるたびに係数を更新していく学習方法を 逐次学習 といいます。
これにより、カルマンフィルタを用いたガイダンスでは、数値予報モデルが変更された場合でも、係数を自動的に更新しながら新しい予測特性に適応することができるのです。
一方、過去のデータを使って係数をまとめて学習し、その後は係数を固定して使う方法を 一括学習 といいます。
一括学習型のガイダンスでは、数値予報モデルが変更されて予測特性が変わった場合、必要に応じて新しいデータを使って係数を作り直す必要があります。
それに対して、カルマンフィルタを用いた逐次学習では、運用しながら係数を更新できるため、数値予報モデルの変更にも対応しやすいのです。
てるらん予測して、観測と比べて、予測式を少しずつ直していくのか!だから、数値予報モデルが変わっても追いついていけるんだね!
したがって、数値予報モデルの改良等によりその予測特性が変化した場合でも、カルマンフィルタに基づく天気予報ガイダンスでは、予測と観測を繰り返すことでガイダンスに用いる予測式の係数が変化し、数値予報モデルの変更に柔軟に対応することができますので、答えは 正 となります。
以上より、本問の解答は、(a) 正 (b) 誤 (c) 正 (d) 正 とする 2 となります。


 ポチップ
書いてある場所:P278〜285(ガイダンス、系統誤差、MOS、PPM)、P286〜289(カルマンフィルタ、ニューラルネットワーク)
 ポチップ
書いてある場所:P387〜393(ガイダンス)、P389〜391(カルマンフィルタ、ニューラルネットワーク、ロジスティック回帰)
 ポチップ
書いてある場所:P393〜399(ガイダンス)、P395〜397(カルマンフィルタ、ニューラルネットワーク、ロジスティック回帰)
令和7年度数値予報解説資料集 第1章 1.6 ガイダンス(気象庁)
書いてある場所:「ガイダンスの役割」「逐次学習」「一括学習」(系統誤差の補正)
数値予報課報告・別冊第64号 ガイダンスの解説 第1章(気象庁予報部)
書いてある場所:「ガイダンスの概念」「系統誤差」「モデル地形」
試験問題は「一般財団法人 気象業務支援センター」様の許可を得て掲載しています。
当記事の解説は「一般財団法人 気象業務支援センター」様とは無関係ですので、情報の誤りや不適切な表現があった場合には、お問い合わせからご連絡ください。
また、当記事に掲載された内容によって生じた損害等の一切の責任を負いかねますのでご了承ください。
コメント