問4普通
気象庁が行っている数値予報における品質管理と客観解析について述べた次の文 (a) 〜 (d) の正誤の組み合わせとして正しいものを、下記の1〜5の中から1つ選べ。
(a) 観測データは、数値予報モデルの予測値から得られる第一推定値と比較され、その差が定められた基準を満たさない場合は、客観解析には用いられない。
(b) 解析と予測を繰り返す解析予報サイクルにより、海上など観測データが少ない領域でも解析精度の向上が期待できる。
(c) 全球解析では、第一推定値の誤差の設定において、気候学的な誤差に加えて、全球アンサンブル予報から見積もられる日々変動する大気の状態に応じた誤差が用いられている。
(d) メソ解析では、水蒸気や雲・降水に関連する観測データとして、アメダス湿度計データ、解析雨量、レーダー反射強度など、全球解析では利用されていない観測データが同化されている。
本問は、数値予報における品質管理と客観解析に関する問題です。
数値予報の流れ(予備知識)
数値予報 とは、大気の状態を風・気温・気圧・水蒸気量などの数値で表し、物理法則にもとづいてコンピュータで将来の大気の状態を予測することです。
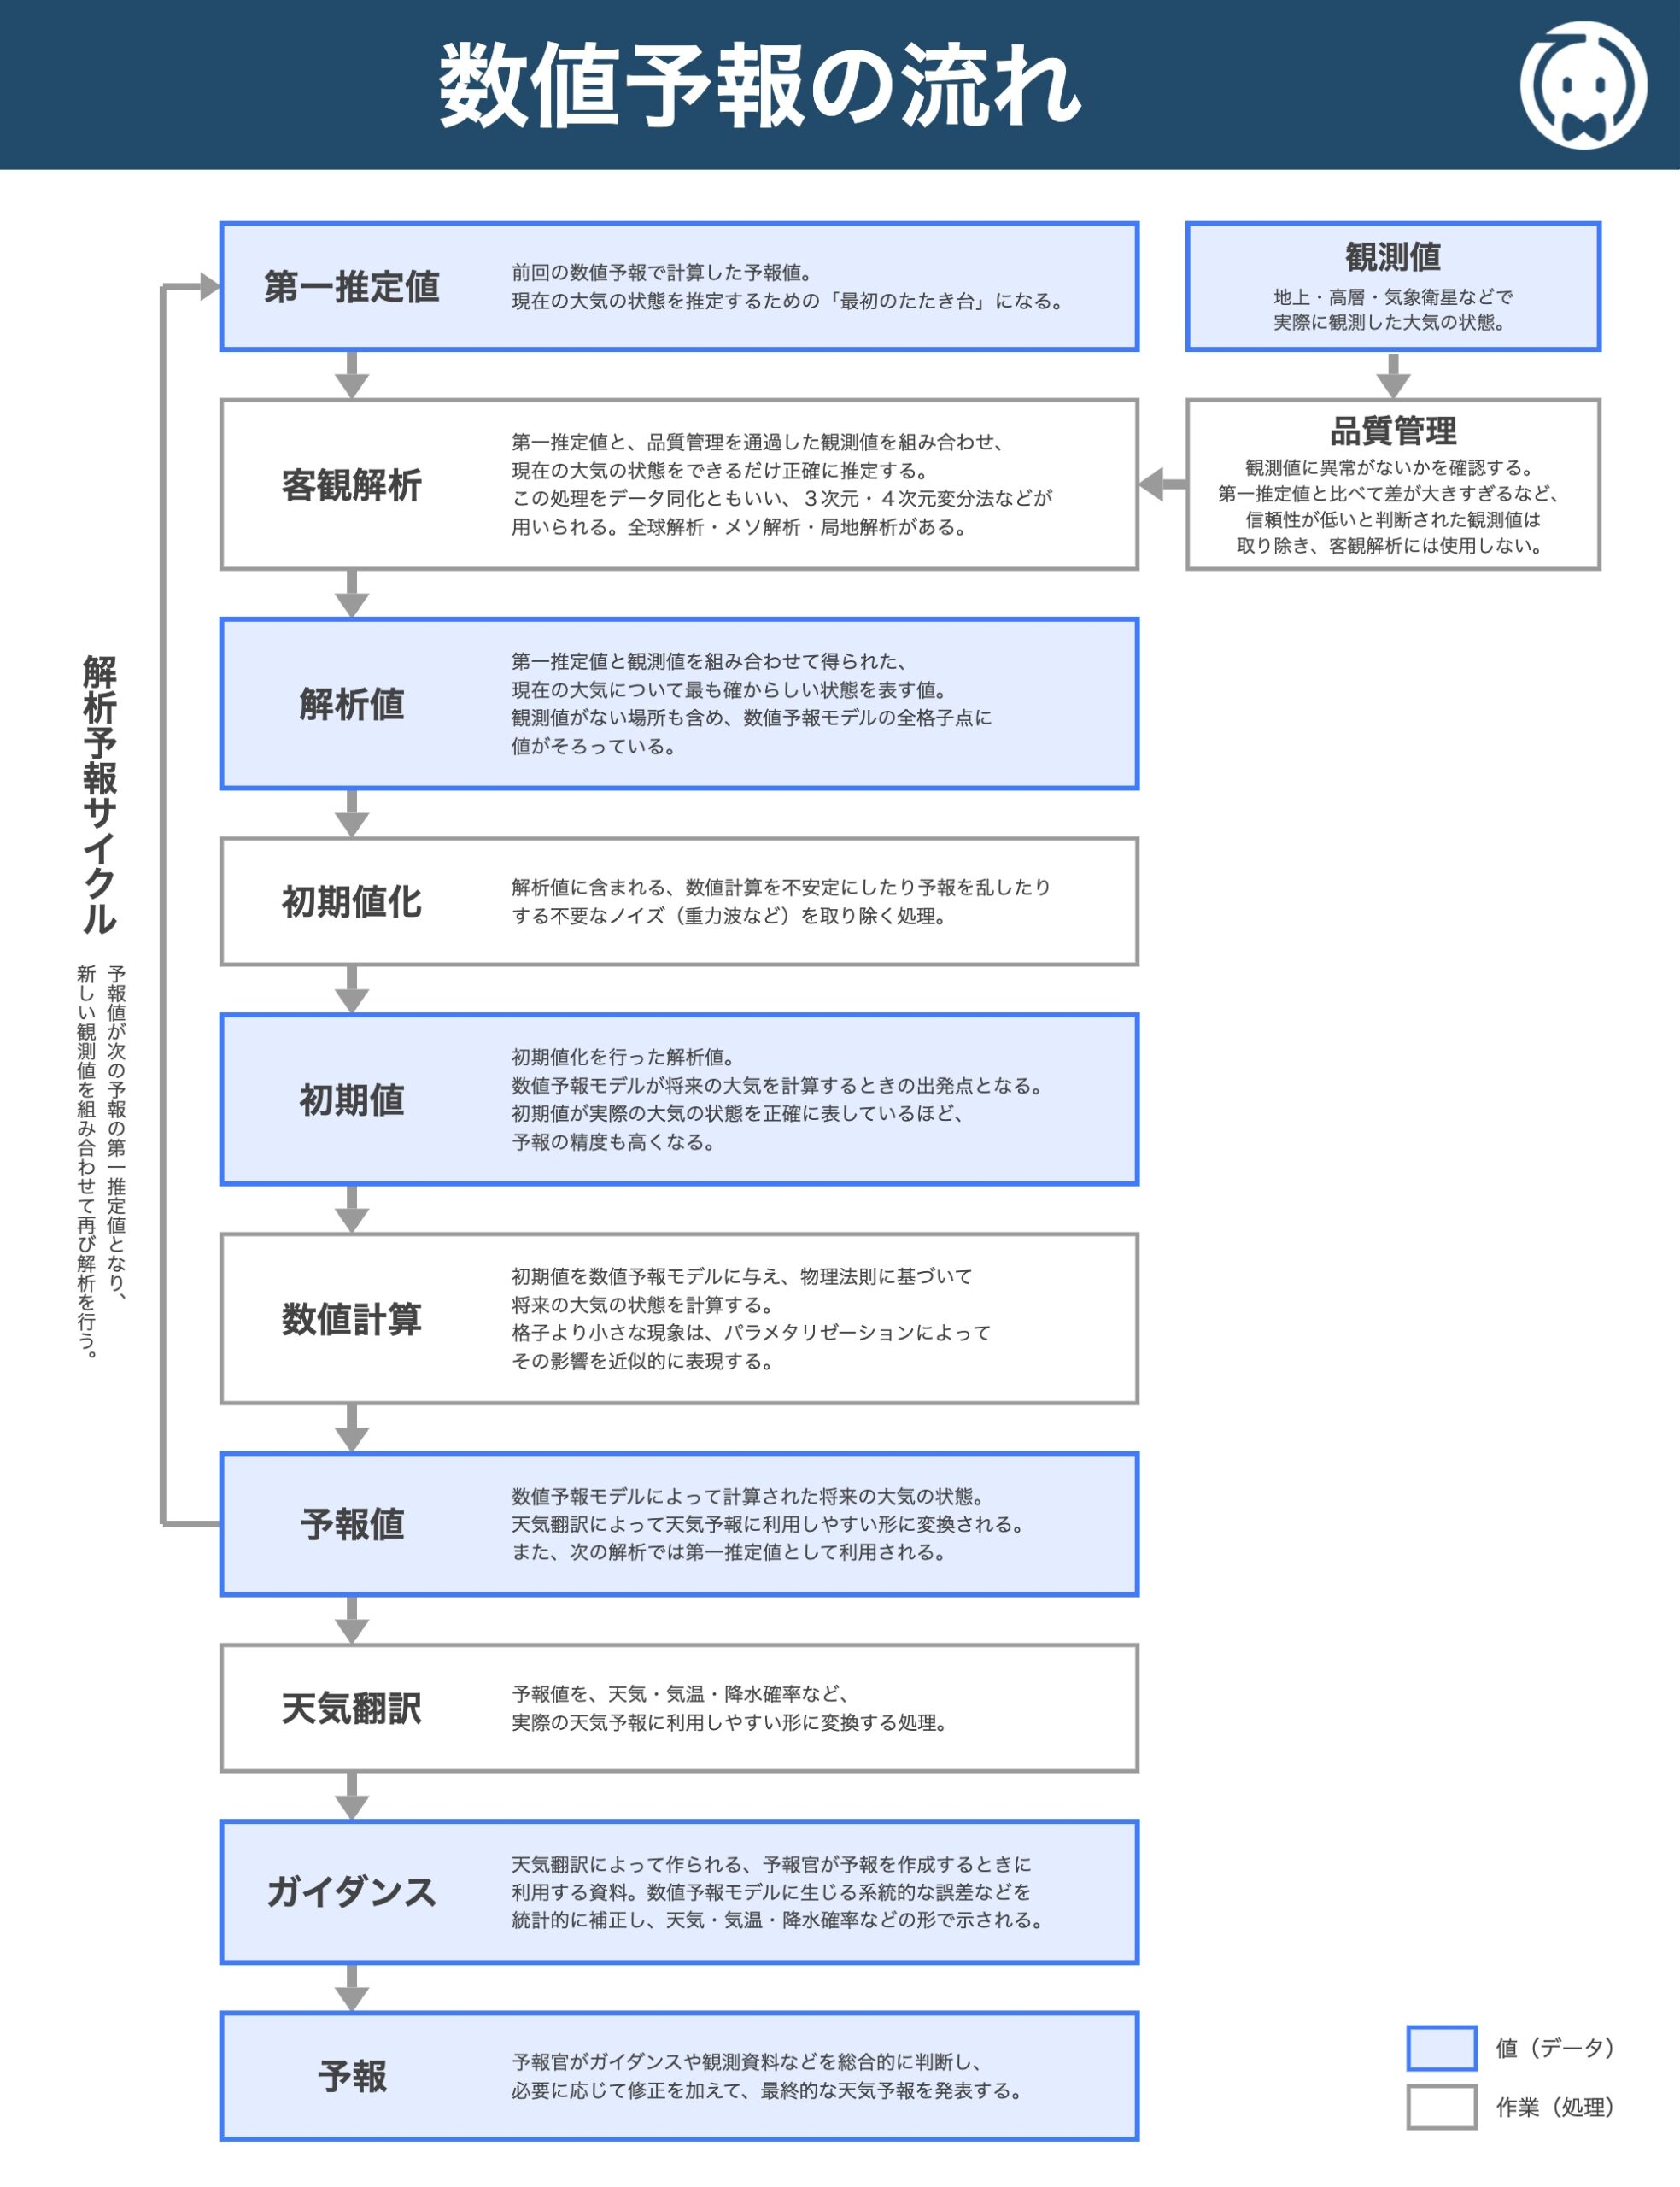
まず、現在の大気の状態を推定するための「最初のたたき台」となるのが、第一推定値 です。
第一推定値には、前回の数値予報で計算された予報値が使われます。
また、地上・高層・気象衛星などで実際に観測した値である 観測データ も使用します。
ただし、観測データには、測器の故障や人為的なミスなどによって、実際の大気の状態とはかけ離れた異常なデータが含まれることがあります。
そこで、まず観測データに異常がないかを確認し、信頼性が低いと判断されたデータを取り除きます。
この作業を 品質管理 といいます。
次に、品質管理を通過した観測データと第一推定値を組み合わせて、現在の大気の状態をできるだけ正確に推定します。
この作業を 客観解析 といいます。
客観解析は、観測データの情報を数値予報モデルに取り込む(同化する)ことから、データ同化 とも呼ばれます。
客観解析によって得られた、現在の大気の状態を最も確からしく表す値を 解析値 といいます。
解析値は、観測データが存在しない場所も含めて、数値予報モデルのすべての格子点に値がそろっています。
ただし、解析値には、数値計算を不安定にするノイズ(重力波など)が含まれていることがあります。
そこで、このようなノイズを取り除く 初期値化 を行います。
初期値化を行った解析値が、数値予報の 初期値 となります。
初期値が実際の大気の状態を正確に表しているほど、その後の予報も正確になります。
そのため、精度の高い初期値をつくることが、数値予報では非常に重要です。
そして、この初期値を数値予報モデルに与え、物理法則にもとづいて将来の大気の状態を計算します。
この計算結果が 予報値 です。
予報値は、そのままでは一般向けの天気予報として利用できる形になっていません。
そこで、予報値を天気・気温・降水確率など、予報に利用しやすい形に変換します。
この変換を 天気翻訳 といいます。
こうして作られた資料が ガイダンス です。
予報官は、このガイダンスを参考にしながら、気象状況などを考慮して判断・修正し、最終的な天気予報を発表します。
また、数値予報で得られた予報値は、次の客観解析を行う際の第一推定値としても使われます。
つまり、
- 客観解析で解析値をつくる
- 初期値化を行って初期値をつくる
- 数値予報で予報値を計算する
- その予報値を次の客観解析の第一推定値として使う
という流れが繰り返されます。
このように、解析と予報を繰り返していく仕組みを 解析予報サイクル といいます。
それでは、選択肢を1つずつ見ていきましょう。
本問の解説:(a) について
(問題)観測データは、数値予報モデルの予測値から得られる第一推定値と比較され、その差が定められた基準を満たさない場合は、客観解析には用いられない。
→ 答えは 正 です。
第一推定値 とは、前回の数値予報で計算した予報値のことです。
簡単にいうと、前回の数値予報で「今の時刻の大気がどうなっているか」を予測した値のことです。
たとえば、前回の数値予報で「今ごろは、この場所で気温が25℃、南風が5m/sになっているだろう」と予測していたとします。
この予測値が、今回の客観解析で使用する第一推定値となります。
客観解析 とは、第一推定値と観測データを組み合わせて、現在の大気の状態をできるだけ正確に推定する作業のことです。
簡単にいうと、第一推定値を、観測データで修正する作業です。
ただし、観測データはそのまま使えるわけではありません。
異常な観測データを客観解析に使用してしまうと、その先の数値予報の結果もおかしくなってしまいます。
そこで、客観解析の前には、観測データと第一推定値を比較し、観測データが妥当な値かどうかを 品質管理 として確認します。
第一推定値との差が大きすぎる観測データは、観測機器の異常などによる誤った値である可能性があるため、定められた基準に基づいて客観解析から除外します。
(なお、第一推定値の精度が特に悪いときは、正しい観測データであっても、このチェックで取り除かれてしまうことがあります。)
したがって、観測データは、数値予報モデルの予測値から得られる第一推定値と比較され、その差が定められた基準を満たさない場合は、客観解析には用いられませんので、答えは 正 となります。
本問の解説:(b) について
(問題)解析と予測を繰り返す解析予報サイクルにより、海上など観測データが少ない領域でも解析精度の向上が期待できる。
→ 答えは 正 です。
解析予報サイクル とは、客観解析で解析値をつくり、初期値化を経て初期値となり、数値予報で予報値を計算し、その予報値を次の客観解析の第一推定値として使う、という流れを繰り返す仕組みのことです。
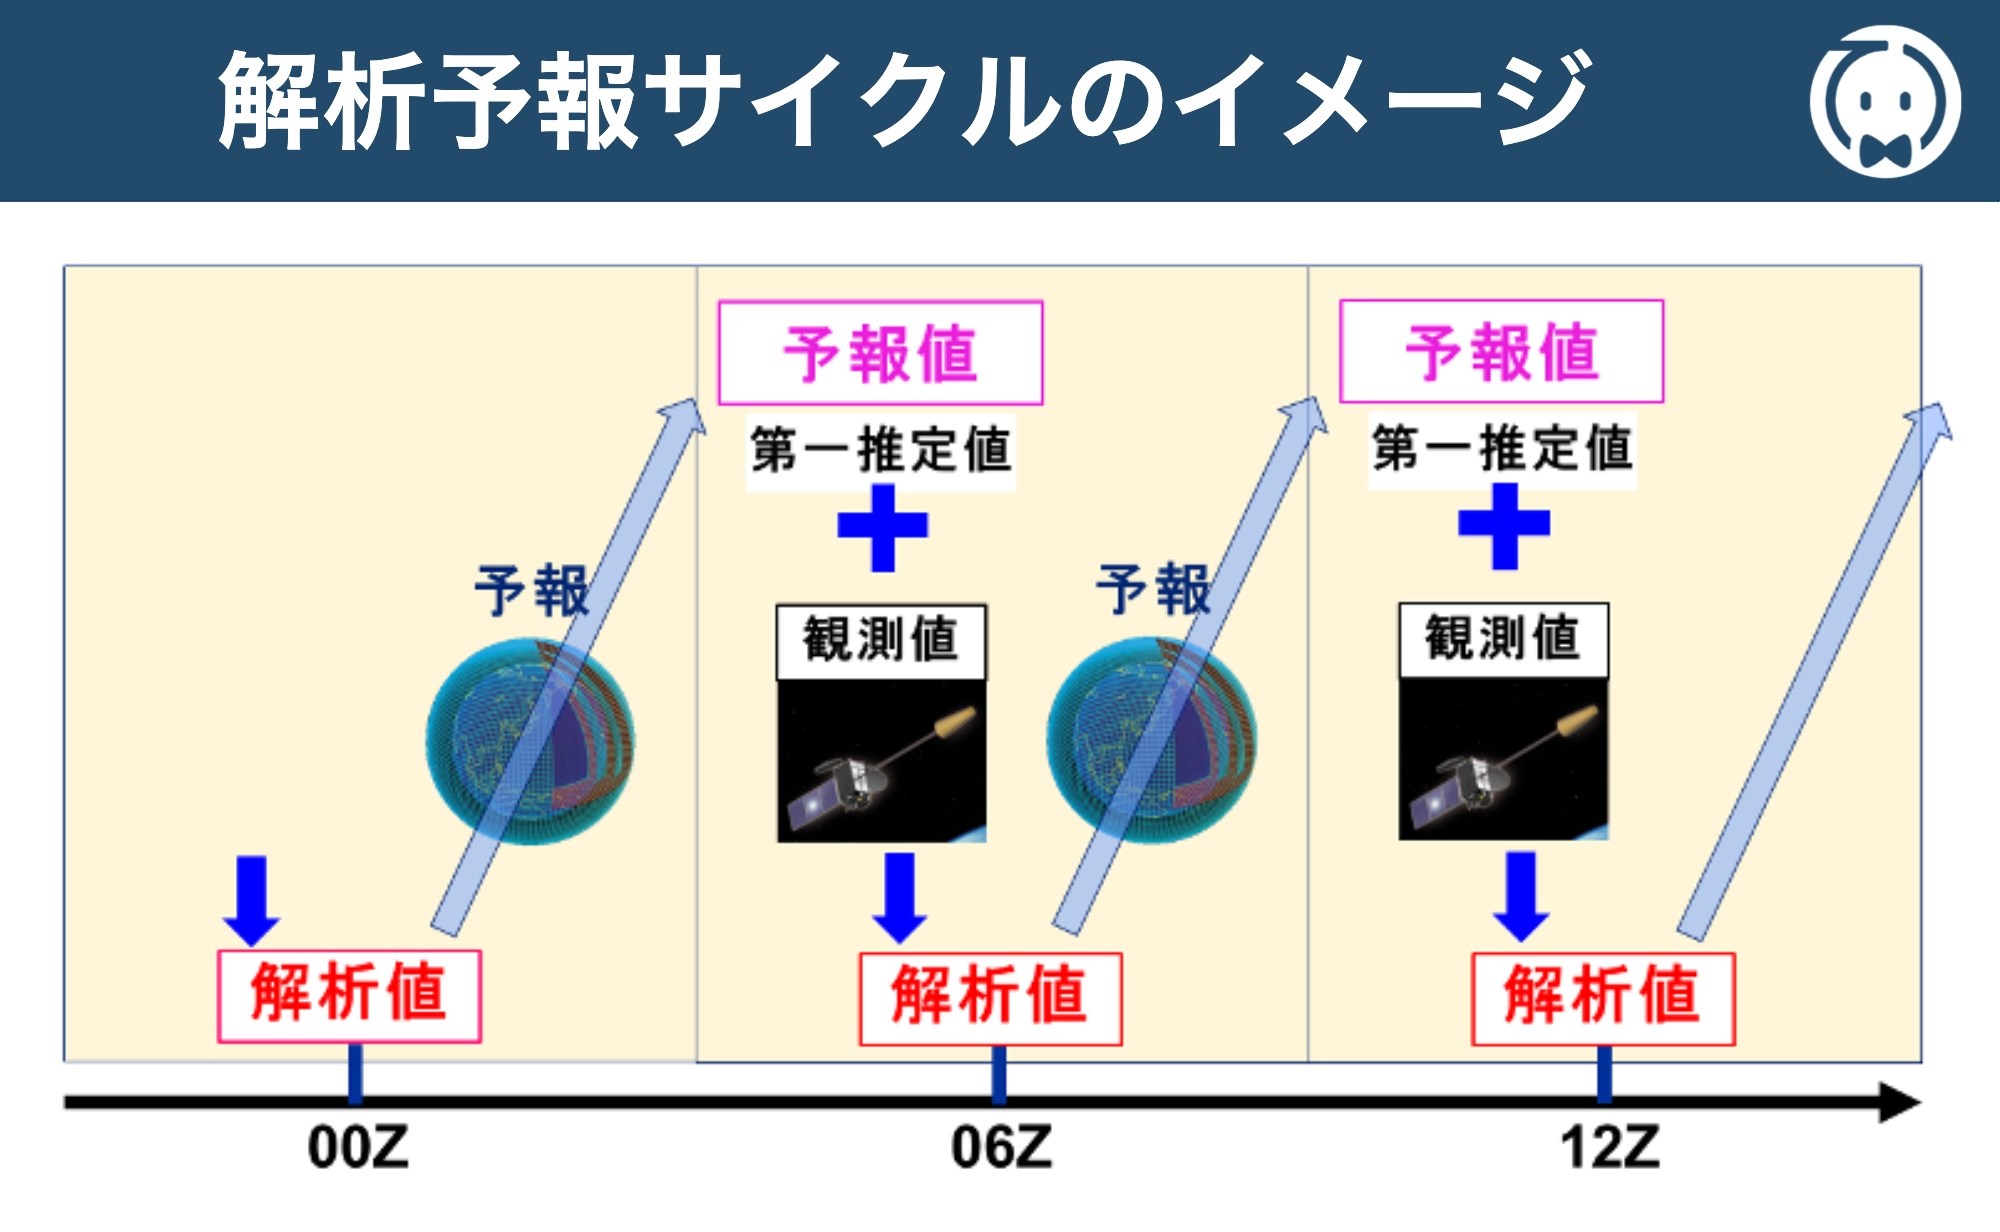
観測データは、観測施設の多い陸上には多いですが、海上にはあまりありません。
そのため、客観解析を1回行うと、陸上付近の第一推定値は精度良く修正できますが、海上の第一推定値は観測データが少ないのであまり修正できません。
しかし、数値予報では、大気の流れを計算するため、陸上で得られた観測データの情報は、大気の流れに沿って周囲へ広がっていきます。
例えば、中緯度では偏西風が吹いているため、観測データが多い大陸東岸の情報が、偏西風によって観測データが少ない東の海上へと運ばれていきます。
この予測値を次の第一推定値として使うことで、海上の解析値にも、大陸東岸の観測データの情報が反映されることになります。
イメージとしては下図のようなかんじです。
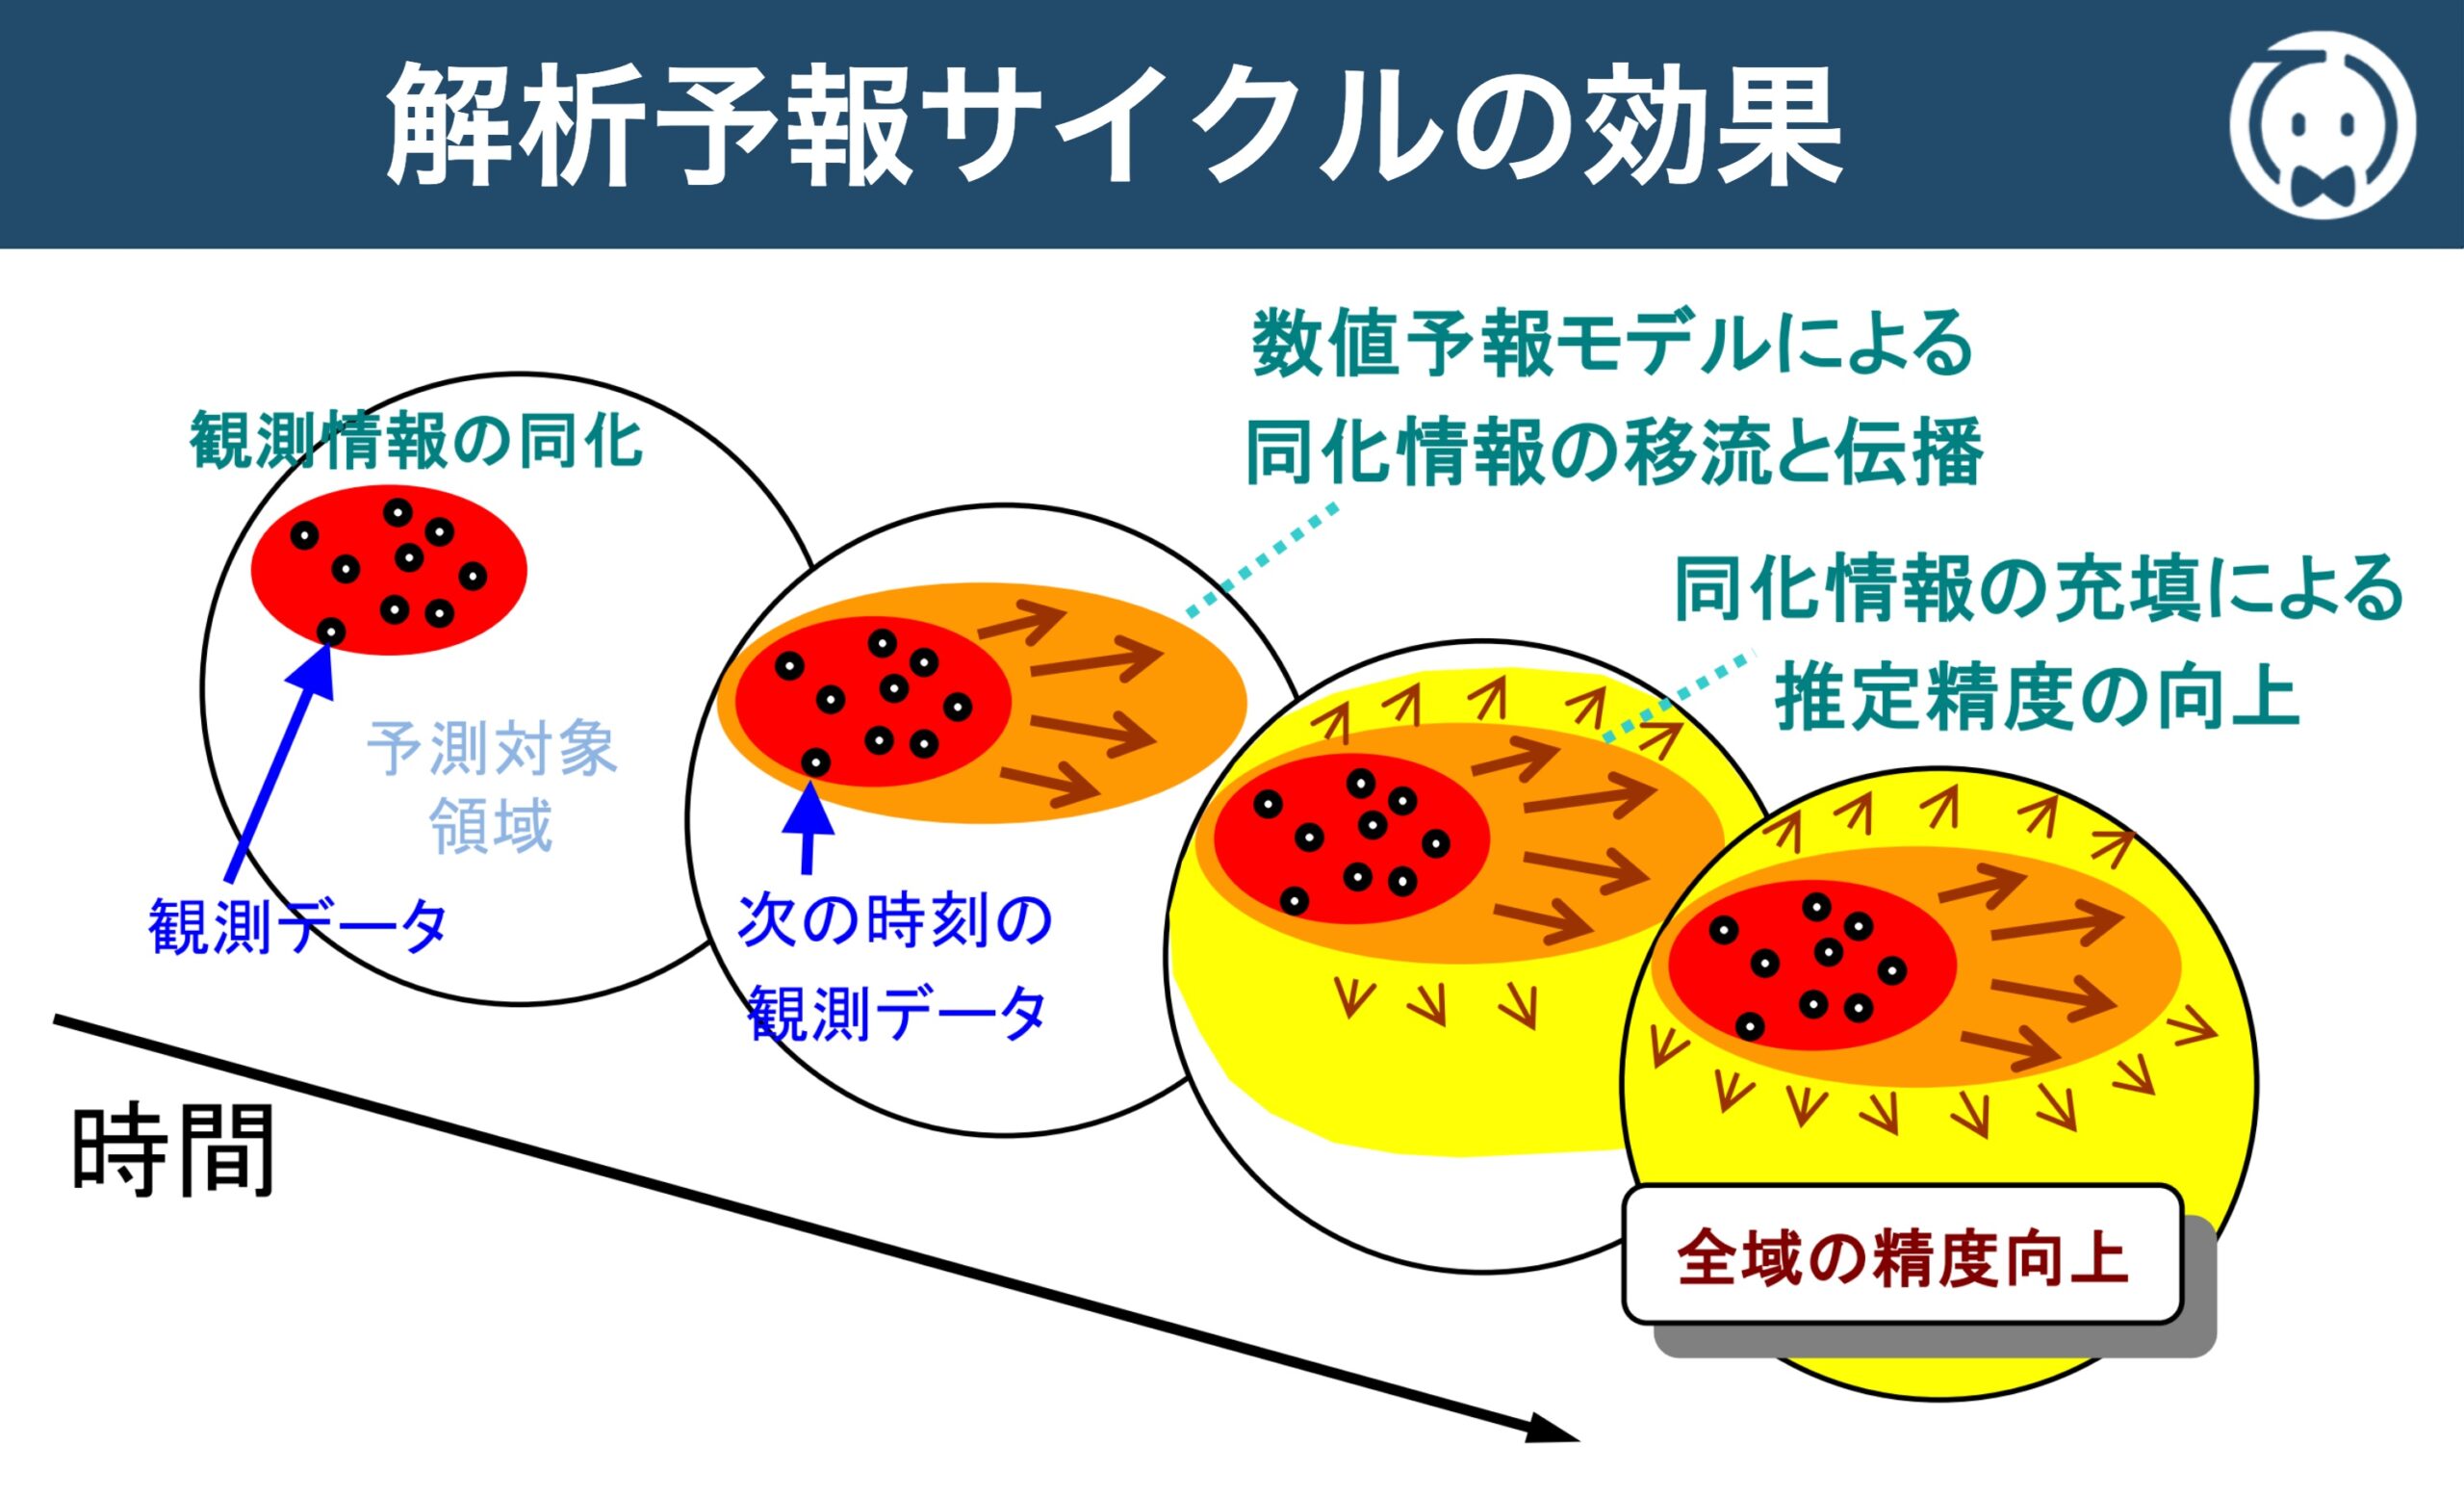
上図の赤い部分は、観測データによって修正された領域です。
数値予報を行うと、その情報が大気の流れに沿って周囲へ運ばれ、オレンジ色の部分まで広がります。
これを次の第一推定値として使い、また新しい観測データで修正する、という解析予報サイクルを繰り返すことで、黄色の部分のように予測対象領域の全域で精度が向上していきます。
このように、解析予報サイクルを繰り返すことで、観測データが少ない領域でも、解析の精度を向上させることができるのです。
したがって、解析と予測を繰り返す解析予報サイクルにより、海上など観測データが少ない領域でも解析精度の向上が期待できますので、答えは 正 となります。
本問の解説:(c) について
(問題)全球解析では、第一推定値の誤差の設定において、気候学的な誤差に加えて、全球アンサンブル予報から見積もられる日々変動する大気の状態に応じた誤差が用いられている。
→ 答えは 正 です。
全球解析 とは、全球モデルの初期値をつくるための客観解析のことです。
客観解析 とは、第一推定値と観測データを組み合わせて、現在の大気の状態をできるだけ正確に推定する作業のことです。
客観解析を行うとき、観測データと第一推定値のどちらをどれくらい信用するかは、それぞれの誤差の大きさに応じて決められます。
そのため、客観解析には、観測データの誤差だけでなく、第一推定値の誤差の情報も必要になります。
第一推定値は前回の数値予報の予測値なので、その誤差の大きさは日によって変わります。
例えば、温帯低気圧が急速に発達しているときは予測が難しく、誤差は大きくなります。
一方、移動性高気圧に覆われて穏やかなときは予測しやすく、誤差は小さくなります。
従来の客観解析では、第一推定値の誤差として、過去の一定期間のデータから統計的に求めた誤差( 気候学的な誤差 )を用いていました。
しかし、気候学的な誤差は日々変わらない値なので、その日の大気の状態に応じた誤差の違いを表すことができません。
そこで、気象庁の全球解析では、気候学的な誤差に加えて、全球アンサンブル予報のメンバー間のばらつきから見積もった誤差も用いています。
アンサンブル予報のばらつきが大きい日は予測が難しい日なので、第一推定値の誤差も大きいと見積もることができます。
このように、日々変動する大気の状態に応じた誤差を取り入れた手法を ハイブリッド同化 といいます。
 てるらん
アンサンブル予報のばらつきを見れば、その日の第一推定値がどれくらい信用できるかが分かるんだね!
したがって、全球解析では、第一推定値の誤差の設定において、気候学的な誤差に加えて、全球アンサンブル予報から見積もられる日々変動する大気の状態に応じた誤差が用いられていますので、答えは 正 となります。
本問の解説:(d) について
(問題)メソ解析では、水蒸気や雲・降水に関連する観測データとして、アメダス湿度計データ、解析雨量、レーダー反射強度など、全球解析では利用されていない観測データが同化されている。
→ 答えは 正 です。
メソ解析 とは、メソモデルの初期値をつくるために行う客観解析のことです。
メソモデルは、集中豪雨や線状降水帯など、日本付近で発生する比較的小さなスケールの現象を予測するために使われます。
こうしたメソスケールの現象は、水蒸気や雲・降水の分布と深く関係しています。
そこで、メソ解析では、アメダス湿度計データ、解析雨量、レーダー反射強度など、全球解析では利用されていない観測データが同化されています。
これらのデータを同化することで、日本付近の水蒸気や降水の分布をより細かく解析でき、メソモデルの初期値の精度を上げることができるのです。
(なお、解析雨量は、雨量計とレーダーの観測をもとに解析した降水量なので、厳密には観測データそのものではありませんが、メソ解析では降水に関するデータとして同化されています。)
したがって、メソ解析では、アメダス湿度計データ、解析雨量、レーダー反射強度など、全球解析では利用されていない水蒸気や雲・降水に関するデータも同化されているため、答えは 正 となります。
以上より、本問の解答は、(a) 正 (b) 正 (c) 正 (d) 正 とする 1 となります。


書いてある場所:P199〜200(数値予報)
書いてある場所:ー

書いてある場所:P212〜213(数値予報、客観解析)

書いてある場所:P305〜331(数値予報)
試験問題は「一般財団法人 気象業務支援センター」様の許可を得て掲載しています。
当記事の解説は「一般財団法人 気象業務支援センター」様とは無関係ですので、情報の誤りや不適切な表現があった場合には、お問い合わせからご連絡ください。
また、当記事に掲載された内容によって生じた損害等の一切の責任を負いかねますのでご了承ください。
コメント